Una integración que funciona con cien registros en sandbox todavía no está probada. Lo aprendí construyendo, para el área de CRM de la Universidad César Vallejo, la sincronización de reportes de Salesforce hacia tablas de BigQuery. La carga completa de unos 600 mil leads pasó de cerca de 4 horas a unos 30 minutos, y hoy cinco tablas se actualizan cada 15 minutos sin exportaciones manuales.
Aquí cuento qué falló, qué cambié y qué haría igual en el próximo proyecto.
El objetivo y sus condiciones#
El pedido era simple: llevar la data de un reporte de Leads de Salesforce a BigQuery para analizarla fuera del CRM. Dos condiciones marcaron el diseño desde el inicio:
- Acceso restringido. Por la sensibilidad de la información, el acceso en BigQuery es solo a las tablas de la integración, no al conjunto completo.
- Ruta formal de Salesforce. Desarrollo en sandbox, clases de prueba, validación y pase a producción. Como las pruebas de Salesforce no permiten llamadas externas reales, todas las conexiones con Google tenían que poder simularse.
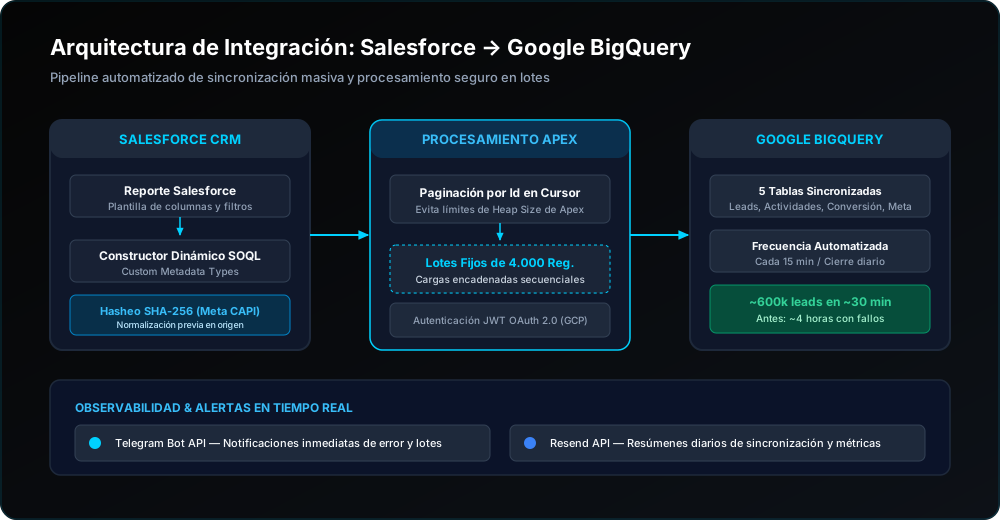
La autenticación se resolvió con una cuenta de servicio: Salesforce firma un token JWT y obtiene un token de acceso temporal de Google en cada ejecución.
La primera versión: funcionaba en sandbox, fallaba en producción#
La primera idea fue ejecutar el reporte y enviar su resultado entero. En sandbox, con unos 100 registros, funcionó. En producción, con unos 500 mil registros y días con cerca de 100 mil actualizaciones, el reporte superaba el límite de filas y la carga fallaba.
Probé partir la data por rangos de fechas (7 días, luego 1 día). No resolvió el problema y además generaba llamadas vacías en los días sin datos.
El cambio de enfoque: el reporte como plantilla#
La solución fue dejar de ejecutar el reporte y usarlo solo como plantilla:
- Se lee la descripción del reporte (objeto, columnas y filtros).
- Con eso se construye una consulta SOQL equivalente.
- La data se envía en lotes fijos de 4.000 registros, ordenados y paginados por Id, sin importar la fecha.
Ese cambio es el que hizo viable el volumen: unos 600 mil registros en unos 30 minutos.
De integración puntual a plataforma configurable#
Cada reporte se registra como un perfil en metadata personalizada de Salesforce: reporte, tabla de destino, objeto, llave y diccionario de columnas. Con eso, agregar una tabla nueva es configuración, no desarrollo:
- Crear el reporte en Salesforce.
- Registrar el perfil.
- Crear la tabla y ejecutar la primera carga.
- Programar los trabajos de sincronización.
Sobre esa base se sumaron la sincronización cada 15 minutos (envía lo modificado en los últimos 30 minutos), un cierre diario que repasa las últimas 25 horas y cargas históricas por tramos de fechas que se encadenan solos.
Datos personales: el hash se calcula antes de salir#
Una de las tablas alimenta Meta Conversions API, que exige correo y teléfono hasheados con SHA-256 y normalizados con sus reglas. El hash se calcula dentro de Salesforce, así que el dato original nunca llega a BigQuery. La configuración indica por perfil qué columnas se hashean y no permite hashear la columna llave.
Pruebas y seguimiento#
- Pruebas: 23 clases Apex y 20 clases de prueba, con una capa de inyección de dependencias y simuladores de Google, BigQuery, Resend y Telegram.
- Seguimiento: un bot de Telegram para el día a día; el correo quedó solo para errores, después de que los avisos de inicio y fin llenaran las bandejas.
Otros problemas que aparecieron en el camino#
- Campos con el mismo nombre en varios objetos: perfiles y diccionario de alias por reporte.
- Límite de cambios de esquema en BigQuery: recrear la tabla en una sola sentencia, guardando y restaurando sus permisos.
- Filtros entre objetos rechazados por Salesforce: el traductor de filtros reubica las subconsultas al nivel superior.
- Un perfil mal configurado detenía a todos: validación por perfil y una regla de operación clara antes de agregar columnas.
Resultado#
| | Hoy | | :--- | :--- | | Carga completa (~600 mil leads) | ~30 minutos (antes ~4 horas) | | Frecuencia | Cada 15 minutos en horario laboral, más cierre diario | | Tablas en producción | 5 | | Tabla nueva | Configuración, sin código nuevo | | Datos personales para Meta | Hasheados con SHA-256 antes de salir de Salesforce |
Lo que me llevo#
- Probar con el volumen real lo antes posible. Cien registros esconden los límites que aparecen con medio millón.
- Convertir integraciones puntuales en plataformas configurables. La siguiente tabla cuesta minutos, no un despliegue.
- Proteger el dato sensible en el origen. Si no tiene que viajar en claro, que no viaje.
- Seguir la ruta formal de despliegue y documentar cada versión. Hace que cada cambio en producción sea predecible.
Si estás armando una integración parecida, puedes ver el resumen del proyecto en mi portafolio.